
Das Wichtigste
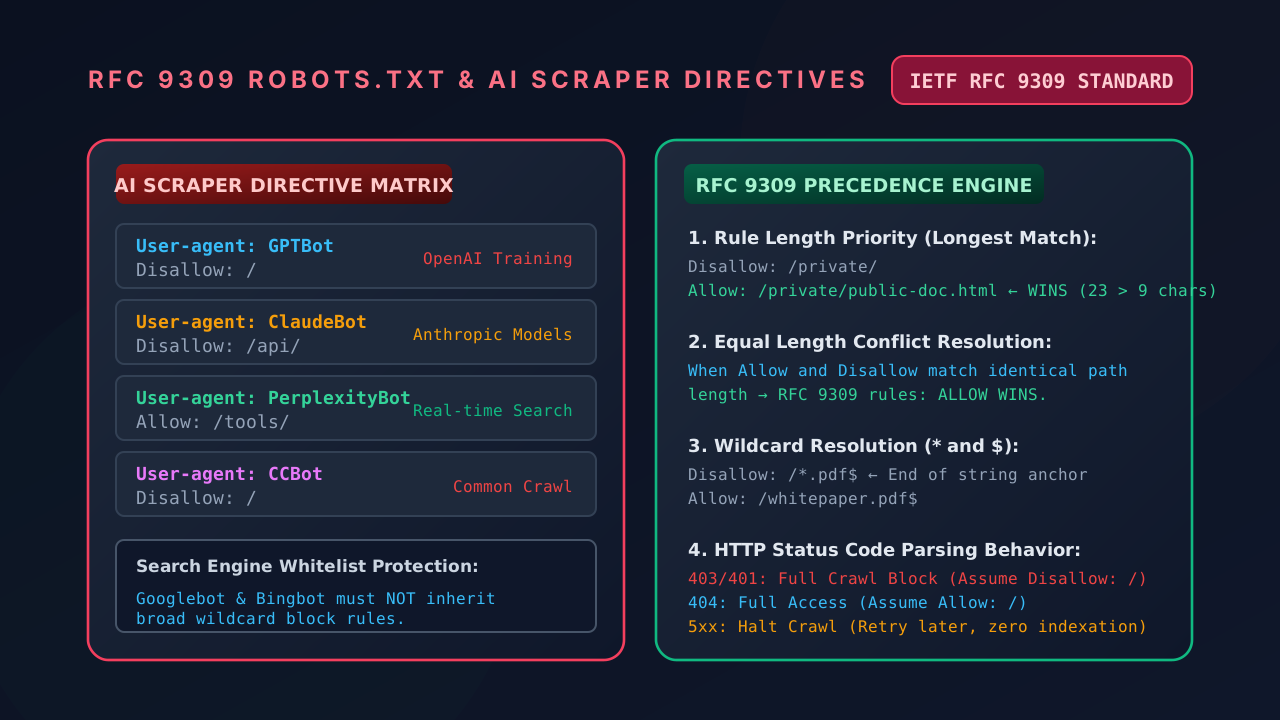
- Der IETF RFC 9309-Standard formalisiert robots.txt und legt die Rangfolge nach dem längsten Pfadabgleich fest.
- Bei gleich langen Pfadkonflikten zwischen Allow und Disallow bestimmt RFC 9309 explizit, dass Allow Vorrang hat.
- HTTP 403- und 401-Statuscodes bei robots.txt blockieren das gesamte Crawling der Website, während HTTP 404 vollen Zugriff gewährt.
Die Standardisierung des Robots Exclusion Protocol
Über fast drei Jahrzehnte hinweg fungierte die Datei robots.txt als informelle De-facto-Konvention im Web. Im September 2022 kodifizierte die Internet Engineering Task Force (IETF) die Spezifikation offiziell als RFC 9309: Robots Exclusion Protocol.
Das Verständnis von RFC 9309 ist unverzichtbar für moderne Webanwendungen, um geschützte Inhalte vor ungefragtem Scraping für LLM-Trainingsdaten abzusichern und gleichzeitig eine fehlerfreie Indexierung durch reguläre Suchmaschinen sicherzustellen.
Zum Testen, Validieren und Debuggen Ihrer Direktiven in Echtzeit nutzen Sie unseren robots.txt-Tester. Für kryptografische Werkzeuge und Web-Workflows entdecken Sie auch den Token-Generator sowie den AES-256-Verschlüsselungsleitfaden.
RFC 9309 Rangfolgematrix & Platzhalter-Auflösung
RFC 9309 definiert deterministische Regeln zur Auflösung kollidierender Allow- und Disallow-Direktiven. Suchmaschinen-Crawler (Googlebot, Bingbot) wenden diesen Algorithmus strikt an:
1. Die Longest-Match-Regel (Längste Übereinstimmung)
Direktiven werden anhand ihrer Pfadlänge (Zeichen- bzw. Oktettanzahl) bewertet. Die Regel mit dem längsten Pfadmuster besitzt absolute Priorität – unabhängig von der Reihenfolge der Zeilen in der Datei:
User-agent: *
Disallow: /katalog/
Allow: /katalog/oeffentliche-probe.html- Beim Zugriff auf
/katalog/oeffentliche-probe.htmlumfasst derAllow-Pfad 32 Zeichen, während derDisallow-Pfad lediglich 9 Zeichen lang ist. - Ergebnis:
Allowgewinnt. Die Seite ist crawlbar und wird indiziert.
2. Tiebreaker bei identischer Pfadlänge (Allow gewinnt immer)
Wenn eine Allow- und eine Disallow-Regel mit exakt identischer Zeichenlänge auf dieselbe URI zutreffen:
User-agent: *
Disallow: /api/v1
Allow: /api/v1- Nach RFC 9309 Abschnitt 2.2.2 hat die am wenigsten restriktive Direktive Vorrang.
- Ergebnis:
Allowgewinnt. Dem Crawler ist der Zugriff auf/api/v1gestattet.
3. Platzhalter-Semantik (* und $)
*entspricht 0 oder mehr beliebigen Zeichen.$verankert das Pfadmuster am Ende der URL-Zeichenkette.
# Alle PDF-Dokumente in sämtlichen Unterverzeichnissen sperren
Disallow: /*.pdf$

# Ein spezifisches technisches Whitepaper explizit freigeben
Allow: /docs/architektur-whitepaper.pdf$
Steuerung von generativen KI-Scrapern & LLM-Crawlern
Generative KI-Modelle setzen autonome Web-Crawler ein, um Trainingskorpora zu erstellen. Diese Bots agieren unabhängig von herkömmlichen Suchmaschinen-Crawlern:
| Crawler-Identität | User-Agent-Token | Betreiber / Zweck | Empfohlene Maßnahme |
|---|---|---|---|
| GPTBot | GPTBot | OpenAI (Modell-Vortraining) | Blockieren bei vertraulichen Inhalten |
| ChatGPT-User | ChatGPT-User | OpenAI (Echtzeit-Benutzerabfragen) | Erlauben für Traffic-Zuweisung |
| ClaudeBot | ClaudeBot | Anthropic (Modelltraining) | Selektiv nach Verzeichnis steuern |
| PerplexityBot | PerplexityBot | Perplexity AI (Suche & Zitate) | Erlauben für Zitate & KI-Sichtbarkeit |
| CCBot | CCBot | Common Crawl (Öffentlicher Datensatz) | Blockieren zum Schutz vor Scraping |
| Bytespider | Bytespider | ByteDance / TikTok | Ratenbegrenzen oder sensible Pfade sperren |
# Empfohlene Enterprise-Konfiguration zur KI-Crawler-Steuerung
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
Disallow: /

User-agent: PerplexityBot
Allow: /
Disallow: /api/
Disallow: /internal/

# Explizite Erlaubnis für reguläre Suchmaschinen-Crawler
User-agent: Googlebot
User-agent: Bingbot
Allow: /
Disallow: /internal/

# Sitemap-Deklaration
Sitemap: https://www.devomnitools.com/sitemap-index.xml
HTTP-Statuscodes & Fehlerbehandlung
Die HTTP-Antwort Ihres Webservers auf Anfragen an robots.txt bestimmt das Verhalten aller Crawler maßgeblich:
- HTTP 200 (OK): Der Crawler verarbeitet und respektiert alle definierten Direktiven.
- HTTP 401 / 403 (Unauthorized / Forbidden): Der Crawler interpretiert dies als vollständige Crawling-Sperre (
Disallow: /). Keine Unterseiten werden gecrawlt. - HTTP 404 (Not Found): Der Crawler geht von voller Zugriffsfreigabe aus (
Allow: /). Alle öffentlich erreichbaren Seiten werden gecrawlt. - HTTP 5xx (Server Error): Der Crawler bricht das Crawling sofort ab und versucht es zu einem späteren Zeitpunkt erneut, um den Server zu schonen und Fehlindexierungen zu verhindern.
FAQ
Was ist der IETF RFC 9309 und warum ist er wichtig?
Veröffentlicht im September 2022 formalisiert RFC 9309 das Robots Exclusion Protocol (REP). Er standardisiert die Platzhaltersyntax (* und $), legt Pfadlängen-Prioritäten fest, definiert die Handhabung von HTTP-Fehlercodes und setzt ein Parsing-Dateilimit von 500 KiB fest.
Wie sollten moderne KI-Scraper (GPTBot, ClaudeBot, CCBot) in der robots.txt gesteuert werden?
Sprechen Sie jeden KI-Crawler gezielt über dessen spezifischen User-agent-Token an. Die Deklaration von 'User-agent: GPTBot' mit 'Disallow: /' blockiert das OpenAI-Modelltraining, ohne Suchmaschinen wie Googlebot oder Bingbot zu beeinträchtigen.
Was passiert, wenn eine Allow- und eine Disallow-Regel identische Pfadlängen aufweisen?
Gemäß RFC 9309 Abschnitt 2.2.2 gilt bei identischer Oktettlänge die am wenigsten restriktive Direktive: Allow gewinnt gegenüber Disallow.